
Pyspark ML es un módulo de Apache Spark que se utiliza para entrenar modelos predictivos sobre DataFrames. Su objetivo no solo es ese, sino que también permite realizar otra serie de operaciones orientadas al machine learning. Por ejemplo, la imputación de valores perdidos o la estandarización de variables que agilizan en gran medida todo el proceso de entrenamiento.
Una ventaja de Pyspark ML frente a otras librerías de machine learning es la posibilidad de entrenar modelos sobre datasets muy grandes. Además, se puede hacer de forma distribuida. Esto cobra un papel crucial cuando tenemos un gran volumen de datos sobre los que queremos realizar el entrenamiento, pues Pyspark ML permite repartir el procesamiento entre varios nodos. De esta manera, facilita la tarea de preparación de variables, la generación de predicciones y la evaluación de los resultados dentro del mismo flujo de trabajo y en un entorno pensado para escalar en caso de que fuera necesario.
En este artículo, veremos una introducción práctica al entrenamiento de modelos con PySpark ML. Además, analizaremos los conceptos básicos de transformadores, estimadores y pipelines, que son la base para trabajar de forma reproducible y ordenada en proyectos de Machine Learning con Spark.
Spark MLlib vs Spark ML
Antes de empezar a entrenar modelos con PySpark, conviene aclarar una confusión habitual. No es lo mismo pyspark.mllib que pyspark.ml. Ambas, aunque pueda parecer que funcionan de la misma manera, tienen diferencias que hay que conocer.
Por un lado, pyspark.mllib es la API antigua y basada en RDDs que actualmente se considera obsoleta para la mayoría de casos de uso. Por otra parte, pyspark.ml es la API moderna, construida sobre DataFrames y es la opción recomendada para desarrollar flujos de Machine Learning en Spark.
Esta diferencia no es solo un cambio de nombres. Trabajar con DataFrames permite integrar mejor el preprocesamiento, la preparación de variables, el entrenamiento de modelos y la evaluación dentro de los pipelines. Así pues, en este artículo nos centraremos en pyspark.ml, que es la forma actual y más práctica de construir modelos de Machine Learning con PySpark.
Flujo de entrenamiento en PySpark ML
El proceso de entrenamiento en PySpark ML, al igual que ocurre en otras librerías de Machine Learning, no consiste únicamente en seleccionar un algoritmo, ejecutar un método y obtener una predicción. Para construir un modelo que genere resultados útiles, es necesario seguir una serie de pasos ordenados. De esta manera, será más fácil preparar los datos, entrenar el modelo y comprobar posteriormente si realmente es capaz de realizar una generalización con información que no ha visto antes.
Normalmente, el punto de partida será un DataFrame de Spark que contenga los datos originales con los que se quiere trabajar. Antes de utilizar estos datos en un modelo, será necesario realizar una primera fase de limpieza y preparación. En esta etapa, se pueden llevar a cabo distintas operaciones. Por ejemplo, eliminar registros duplicados, corregir tipos de datos, tratar valores nulos, descartar registros que no sean válidos o crear nuevas variables a partir de las columnas existentes.
Antes de usar estos datos para entrenar un modelo, pueden surgir situaciones como la siguiente:
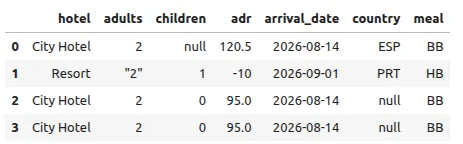
Por ejemplo, a partir de una columna que contenga una fecha, se podrían generar nuevas variables como el día de la semana, el mes o el año. También se podrían calcular importes totales, antigüedades, medias o cualquier otra variable que pueda aportar información relevante al modelo.
Transformaciones de datos y variables
Sin embargo, es importante diferenciar entre las transformaciones generales que pueden aplicarse directamente sobre los datos y aquellas que necesitan aprender información a partir de ellos. Por ejemplo, eliminar duplicados o extraer el mes de una fecha no implica aprender ningún patrón estadístico. En cambio, calcular medias para rellenar valores nulos, escalar variables o convertir categorías en índices, sí puede depender de la distribución de los datos.
Esta diferencia es clave porque las transformaciones que aprenden información no deberían ajustarse utilizando el conjunto completo de datos. Si se usa información del conjunto de test durante la preparación, aunque sea de manera indirecta, se puede producir una fuga de información. Esto se conoce como data leakage. Como consecuencia, el modelo podría parecer más preciso de lo que realmente sería al trabajar con datos nuevos. Esta sería una consecuencia que hay que evitar a toda costa.
Por este motivo, después de realizar una limpieza inicial, el DataFrame debe dividirse en un conjunto de entrenamiento y otro de test. El de entrenamiento se utilizará para ajustar tanto las transformaciones que necesiten aprender información como el propio algoritmo. Por su parte, el conjunto de test se reservará para evaluar el comportamiento del modelo cuando haya finalizado el entrenamiento.
Una vez separados los datos, el siguiente paso consiste en transformar las variables al formato esperado por Spark ML. La mayoría de los algoritmos no reciben cada variable de entrada como una columna independiente, sino que esperan una única columna vectorial que agrupe todas las características utilizadas por el modelo. Por convención, esta columna suele llamarse features, aunque, si se considera necesario, puede usarse otro nombre. Eso sí, siempre configurando el algoritmo correctamente para que lo tenga en cuenta.
Tipos de variables
La forma de preparar esta columna depende del tipo de variables. Mientras que las numéricas pueden usarse directamente si están limpias, las categóricas deben transformarse a formato numérico mediante herramientas como StringIndexer y OneHotEncoder. Tras estos ajustes, todas las variables se combinan usando, por ejemplo, VectorAssembler, que genera la columna vectorial utilizada por el modelo.
En los problemas de aprendizaje supervisado, también es necesario disponer de una variable objetivo. Es decir, la columna que contiene el resultado que queremos que el modelo aprenda a predecir. Normalmente, esta columna suele llamarse label, aunque al igual que ocurre con features, es posible utilizar cualquier nombre si se configura bien.
La variable objetivo dependerá del tipo de problema que se quiera resolver. En clasificación podría representar, por ejemplo, si un cliente realiza una compra, si una operación es fraudulenta o a qué categoría pertenece un registro. En regresión podría representar un valor continuo, como el precio de una vivienda, el importe de una venta o el tiempo necesario para completar una tarea.
Definición del algoritmo
Una vez definidas las transformaciones necesarias, preparado el campo features y establecida la variable objetivo, se puede definir el algoritmo que se utilizará durante el entrenamiento. En este punto, PySpark ML incluye diferentes modelos de clasificación, regresión, clustering y reducción de dimensionalidad, entre otros. Por tanto, será importante saber cuál es el más adecuado para cada caso de uso.
El entrenamiento se realiza mediante el método fit(). Este método recibe el DataFrame de entrenamiento y genera un modelo ajustado. Durante este proceso, el algoritmo analiza la relación existente entre las variables de entrada y la variable objetivo y aprende los parámetros internos necesarios para realizar las predicciones.
Después de entrenar el modelo, éste se puede aplicar sobre el conjunto de test mediante el método transform(). El resultado de esta operación será un nuevo DataFrame que conservará las columnas originales e incorporará las generadas por el modelo. Dichas columnas ya incluyen, entre otras, una nueva que normalmente se llama prediction, y que contendrá la predicción obtenida para cada registro.
Resultados y pipeline
El último paso consistirá en evaluar los resultados obtenidos. Para ello, se comparan las predicciones realizadas por el modelo con los valores reales de la variable objetivo. Las métricas utilizadas dependen del tipo de problema. Normalmente, en problemas de clasificación es común usar métricas como accuracy, precisión, recall, F1-score o área bajo la curva ROC. Por otro lado, en los de regresión se suelen utilizar RMSE (Root Mean Squared Error), MAE (Mean Absolute Error) o R² (coeficiente de determinación).
Por último, es importante entender que, aunque todos estos pasos pueden ejecutarse de forma independiente, PySpark ML permite agrupar muchas de las transformaciones y el propio algoritmo dentro de un pipeline. El pipeline permite definir el flujo completo como una secuencia ordenada de etapas y ajustarlo utilizando únicamente los datos de entrenamiento. Esto es especialmente útil porque, de esta manera, una vez finalizado el entrenamiento, ese mismo flujo puede aplicarse sobre el conjunto de test o sobre nuevos datos, garantizando que se realicen exactamente las mismas transformaciones.
En resumen, el proceso de entrenamiento es bastante exigente y requiere de realizar varios pasos en un orden concreto y buscando una función determinada. Sin embargo, aquí no acaba todo. Es importante conocer otros aspectos fundamentales de PySpark ML como pueden ser cómo usar los transformadores, estimadores, pipelines, modelos predictivos y herramientas de evaluación.
Formato de datos en PySpark ML
PySpark ML trabaja directamente sobre DataFrames de Spark, por lo que no es necesario convertir los datos a estructuras externas antes de entrenar un modelo. Sin embargo, los algoritmos esperan que el DataFrame siga una estructura concreta, especialmente en lo relacionado con las variables de entrada y la variable que se quiere predecir.
Además, es necesario comprobar que las columnas tengan tipos de datos compatibles. Las variables numéricas deben estar correctamente convertidas y no deberían contener valores nulos, infinitos o datos inválidos. Las variables categóricas tampoco pueden incorporarse directamente al vector. Por tanto, tal y como se ha comentado antes, primero deben transformarse mediante componentes como StringIndexer y, cuando sea necesario, usar OneHotEncoder.
Como se puede ver, Spark ML necesita que las variables utilizadas por el modelo estén correctamente tipadas, transformadas y agrupadas en una única columna vectorial. Esta estructura común permite que los diferentes algoritmos y componentes de PySpark ML puedan conectarse entre sí de una forma consistente.
Transformadores en PySpark ML
Los transformadores son componentes de PySpark ML que reciben un DataFrame, aplican una operación sobre sus datos y devuelven un nuevo DataFrame con las columnas transformadas o añadidas. Para ejecutar esta operación, utilizan el método transform().
Es importante tener en cuenta que un transformador no modifica directamente el DataFrame original, ya que los DataFrames de Spark son inmutables. En lugar de eso, genera uno nuevo que conserva las columnas existentes e incorpora el resultado de la transformación.
Uso de VectorAssembler
Un ejemplo que muestra muy bien el uso de un transformador es VectorAssembler, que permite agrupar varias columnas numéricas en una única columna vectorial, y que tal y como hemos mencionado antes, se suele llamar features:
from pyspark.ml.feature import VectorAssembler

assembler = VectorAssembler( inputCols=["nombre", "edad", "ingresos"], outputCol="features" )

df_transformado = assembler.transform(df)
En este caso, VectorAssembler no necesita aprender ninguna información a partir de los datos. Simplemente, toma las columnas que le hemos indicado y las combina siguiendo una regla que hemos definido. Por este motivo, puede utilizarse directamente mediante el método transform().
También existen transformadores destinados a modificar columnas, generar nuevas variables o aplicar modelos ya entrenados. De hecho, cuando se entrena un algoritmo mediante el método fit(), el resultado obtenido es un modelo que también funciona como transformador. Este modelo puede recibir nuevos datos y añadir columnas como prediction o probability.
Así pues, como se puede ver, dentro de PySpark ML se pueden encontrar dos tipos habituales de transformadores. Por un lado, aquellos que aplican operaciones directamente sobre los datos (como VectorAssembler o Tokenizer). Por otra parte, están los modelos entrenados, que transforman un DataFrame generando predicciones a partir de los patrones aprendidos durante el entrenamiento. En ambos casos, reciben un DataFrame y devuelven otro mediante el método transform() sin necesidad de aprender parámetros en ese momento.
Como veremos en el siguiente punto, esta es la principal diferencia de los transformadores con los estimadores, que deben analizar previamente los datos mediante fit() para generar un modelo transformador.
Estimadores y modelos entrenados
Los estimadores son componentes de PySpark ML que necesitan analizar un conjunto de datos para aprender una serie de parámetros antes de realizar una transformación. A diferencia de los transformadores, no se aplican directamente mediante el método transform(), sino que emplean fit() para ajustarse a los datos y generar como resultado un modelo entrenado.
Hay varios estimadores que se suelen usar con bastante frecuencia. Por ejemplo, StringIndexer es un estimador porque necesita recorrer los datos para conocer las categorías existentes y así poder asignarles un número a cada una de ellas. Por otro lado, StandardScaler se usa para para estandarizar las variables numéricas a partir de estadísticas como la media y la desviación estándar. Así, conseguimos transformar sus valores para que trabajen en una escala comparable, evitando que unas variables tengan más peso que otras simplemente por tener valores más grandes.
StringIndexer y LogisticRegression()
También son estimadores los algoritmos predictivos, como una regresión logística, un árbol de decisión o un modelo de regresión lineal. Vamos a verlo en un ejemplo.
from pyspark.ml.feature import StringIndexer
indexer = StringIndexer(
    inputCol="ciudad",
    outputCol="ciudad_indexada"
)
modelo_indexador = indexer.fit(df_train)
df_transformado = modelo_indexador.transform(df_train)
En este ejemplo, StringIndexer es el estimador y modelo_indezador es el modelo entrenado que se obtiene después de ejecutar el método fit(). El estimador establece cómo se realizará el aprendizaje, mientras que el modelo contiene la información aprendida y puede aplicarse después a otros DataFrames como un transformador más mediante transform().
De igual manera, podemos hacer lo mismo con un algoritmo predictivo como puede ser LogisticRegression(). A continuación, lo vemos con otro ejemplo:
from pyspark.ml.classification import LogisticRegression

estimador = LogisticRegression(
    featuresCol="features",
    labelCol="label"
)

modelo = estimador.fit(df_train)
predicciones = modelo.transform(df_test)
En este caso, LogisticRegression representa el algoritmo todavía sin entrenar. Al ejecutar el método fit() sobre el conjunto de entrenamiento, se genera un modelo de regresión logística ajustado que ya contiene los parámetros aprendidos y funciona como un transformador capaz de generar predicciones.
Es importante que los estimadores se ajusten únicamente utilizando los datos de entrenamiento. Si componentes como StringIndexer o StandardScaler se entrenan usando también el conjunto de test, se estará incorporando información que debería permanecer desconocida durante el aprendizaje. Esta situación es muy poco deseable, ya que puede provocar una evaluación demasiado optimista del modelo.
Por tanto, tal y como hemos podido ver, un estimador recibe un DataFrame mediante fit() y devuelve un modelo entrenado. Ese modelo pasa a comportarse como un transformador y puede aplicarse a través de un método transform() sobre el conjunto de entrenamiento, el de test o nuevos datos. Esta relación entre estimadores, modelos y transformadores es una de las bases sobre las que se construyen los pipelines en PySpark ML.
Modelos predictivos
Ahora que hemos visto la diferencia entre los estimadores y los transformadores, el siguiente punto es hablar de los modelos predictivos. Sin embargo, antes que nada, es conveniente saber qué son. Los modelos predictivos son algoritmos de Machine Learning que analizan los datos de entrenamiento para aprender la relación existente entre las variables de entrada y la variable objetivo. Una vez entrenados, pueden aplicar los patrones aprendidos sobre nuevos datos y generar una predicción para cada registro.
En PySpark ML, los modelos predictivos se definen inicialmente como estimadores. Esto significa que, antes de poder realizar predicciones, necesitan ajustarse mediante el método fit() utilizando un DataFrame de entrenamiento que contenga la columna features y la variable objetivo.
from pyspark.ml.classification import LogisticRegression

algoritmo = LogisticRegression(
    featuresCol="features",
    labelCol="label"
)

modelo = algoritmo.fit(df_train)
En este ejemplo, LogisticRegression representa el algoritmo todavía sin entrenar, mientras que la variable modelo contiene el modelo predictivo resultante después de analizar los datos con fit().
Como hemos explicado antes, una vez entrenado, el modelo pasa a funcionar como un transformador y puede aplicarse sobre el conjunto de test o sobre nuevos datos mediante el método transform().
predicciones = modelo.transform(df_test)Este nuevo DataFrame, no solo mantiene las columnas originales. También añade una nueva columna que normalmente se llama prediction y que contiene el resultado calculado por el modelo. Por otro lado, en algunos algoritmos de clasificación también se generan columnas extras, como pueden ser probability o rawPrediction. Estas columnas permiten conocer la puntuación o probabilidad asignada a cada clase.
Modelos de clasificación y de regresión
Ahora bien, es importante destacar que los modelos predictivos que se pueden usar en PySpark ML pueden dividirse principalmente en dos: modelos de clasificación y modelos de regresión.
Los modelos de clasificación se utilizan cuando la variable objetivo representa una categoría. Por ejemplo, determinar si un cliente realizará una compra, si una operación puede ser fraudulenta o a qué grupo pertenece un registro. En este caso, algunos de los algoritmos que se pueden usar son LogisticRegression, DecisionTreeClassifier o RandomForestClassifier entre otros.
Por otro lado, los modelos de regresión suelen usarse cuando el objetivo es predecir un valor numérico continuo. Por ejemplo, el precio de una vivienda, el importe de una venta o la duración de un servicio. Entre los algoritmos de PySpark ML que más destacan están LinearRegression, DecisionTreeRegressor o RandomForestRegressor.
La elección del modelo es uno de los aspectos más importantes a la hora de predecir. Cada algoritmo tiene unas características diferentes y puede comportarse mejor o peor dependiendo del volumen de datos, el tipo de variables, la relación entre ellas y el objetivo del problema. Por eso, lo habitual es entrenar y evaluar diferentes modelos antes de seleccionar el que genere los mejores resultados. Así, nos aseguramos de que el modelo que finalmente es elegido es verdaderamente el que mejores resultados arroja sobre los datos.
Evaluación de resultados
Una vez se ha entrenado el modelo y se han generado las predicciones sobre el conjunto de test, el siguiente paso es evaluar los resultados obtenidos. Esta fase es clave en todo el proceso, pues permite comprobar si el modelo ha aprendido patrones útiles y si es capaz de generar predicciones que sean acertadas sobre datos que no ha utilizado durante el entrenamiento.
Como hemos visto, al aplicar el método transform() sobre el conjunto de test se obtiene un nuevo DataFrame que contiene tanto los valores reales de la variable objetivo como las predicciones realizadas por el modelo. Por lo tanto, la evaluación consiste principalmente en comparar la columna label con la columna prediction.
predicciones = modelo.transform(df_test)

predicciones.select(
    "label",
    "prediction"
).show()
Sin embargo, observar manualmente algunas predicciones no es suficiente para determinar si un modelo funciona correctamente. Para poder medir su rendimiento de una forma objetiva, es necesario utilizar métricas de evaluación. Estas métricas dependerán principalmente de si estamos trabajando con un problema de clasificación o con uno de regresión.
Métricas de problemas de clasificación
En los problemas de clasificación, el objetivo es predecir una categoría. Por ejemplo, se puede intentar determinar si un cliente realizará una compra, si una operación es fraudulenta o si un correo electrónico es spam. En estos casos, PySpark ML proporciona evaluadores como BinaryClassificationEvaluator y MulticlassClassificationEvaluator.
Una de las métricas más conocidas es la exactitud o accuracy, que indica qué proporción de las predicciones realizadas por el modelo son correctas.
from pyspark.ml.evaluation import MulticlassClassificationEvaluator

evaluador = MulticlassClassificationEvaluator(
    labelCol="label",
    predictionCol="prediction",
    metricName="accuracy"
)

accuracy = evaluador.evaluate(predicciones)
Aunque la exactitud puede ser útil, no siempre es suficiente para evaluar correctamente un modelo. Por ejemplo, si el 95 % de las operaciones no son fraudulentas, un modelo que siempre prediga que no existe fraude tendría una exactitud del 95 %, pero no sería capaz de detectar ninguna de las operaciones fraudulentas. Por este motivo, cuando las clases están desbalanceadas, es necesario utilizar otras métricas.
Precision, recall, F1-score y AUC-ROC
Entre las métricas más habituales en clasificación se encuentran precision, recall y F1-score. La precisión indica qué proporción de los registros predichos como positivos eran realmente positivos. Por otro lado, el recall muestra qué proporción de todos los registros positivos existentes ha conseguido detectar el modelo. Por último, F1 combina precision y recall en una única métrica. Como puedes imaginar, esto puede ser especialmente útil cuando se necesita encontrar un equilibrio entre ambas.
Por otro lado, también se puede utilizar el área bajo la curva ROC, conocida como AUC-ROC, para evaluar modelos de clasificación binaria. Esta métrica mide la capacidad del modelo para diferenciar entre las dos clases utilizando las puntuaciones generadas en la columna rawPrediction.
from pyspark.ml.evaluation import BinaryClassificationEvaluator

evaluador = BinaryClassificationEvaluator(
    labelCol="label",
    rawPredictionCol="rawPrediction",
    metricName="areaUnderROC"
)
auc = evaluador.evaluate(predicciones)
Métricas de regresión
En los problemas de regresión el objetivo es predecir un valor numérico continuo. En estos casos, la evaluación se basa normalmente en medir la diferencia existente entre los valores reales y los valores predichos.
RMSE, MAE y R²
Para realizar esta tarea, PySpark ML tiene el evaluador RegressionEvaluator, que permite calcular métricas como RMSE, MAE o R².
from pyspark.ml.evaluation import RegressionEvaluator

evaluador = RegressionEvaluator(
    labelCol="label",
    predictionCol="prediction",
    metricName="rmse"
)

rmse = evaluador.evaluate(predicciones)
Ahora bien, es importante entender qué significan estas tres métricas, pues cada una de ellas representa algo diferente. Por un lado, el RMSE mide la magnitud media del error, pero penaliza especialmente aquellos errores que son más grandes. Esto hace que sea útil cuando se quiere dar una mayor importancia a las predicciones que se alejan mucho del valor real.
Por otro lado, el MAE calcula la diferencia absoluta media entre los valores reales y las predicciones. Su interpretación suele ser más directa, ya que indica cuánto se equivoca el modelo de media utilizando las mismas unidades que la variable objetivo.
Por último, el R² indica qué proporción de la variabilidad de la variable objetivo puede ser explicada por el modelo. Cuanto más próximo se encuentre a 1, mayor será la capacidad explicativa del modelo. Sin embargo, no debe utilizarse de forma aislada, ya que un valor elevado no garantiza necesariamente que los errores sean pequeños o que el modelo vaya a comportarse correctamente con nuevos datos.
Como hemos visto, hay diferentes métricas que se pueden usar para intentar evaluar si los resultados obtenidos son los esperados. Sin embargo, también es importante entender que no existe una única métrica que sea siempre la mejor. La elección dependerá del objetivo real del problema y del coste asociado a cada tipo de error. Por ejemplo, en un modelo para detectar una enfermedad podría ser más importante reducir los falsos negativos, mientras que en un sistema que bloquee operaciones bancarias legítimas también habría que controlar especialmente los falsos positivos.
Errores comunes al usar PySpark ML
Tal y como hemos analizado, PySpark ML es una herramienta muy potente que permite hacer una gran cantidad de análisis. No obstante, también es importante tener en cuenta que, a la hora de trabajar con PySpark ML, es habitual cometer algunos errores que pueden afectar directamente a la calidad del modelo.
Uno de los más importantes es realizar todas las transformaciones antes de dividir los datos entre entrenamiento y test. Esto se debe a que si componentes como StringIndexer o StandardScaler se ajustan utilizando el DataFrame completo, se estará incorporando información del conjunto de test durante el entrenamiento. Esto puede provocar una fuga de información y unos resultados demasiado optimistas.
Otro error común es no preparar correctamente las variables. Es necesario comprobar que las columnas tengan el tipo de dato adecuado, que no contengan valores nulos o inválidos y que las variables categóricas se transformen correctamente. También se debe evitar el uso de identificadores únicos o columnas que contengan información que no estaría disponible en el momento real de realizar la predicción.
Por otra parte, evaluar el modelo con los mismos datos utilizados durante el entrenamiento no permite saber cómo se comportará con información nueva. De ahí, la importancia de que la evaluación se realice sobre un conjunto de test independiente y utilizando métricas adecuadas para el tipo de caso de uso. Por ejemplo, en problemas de clasificación con clases desbalanceadas, utilizar únicamente accuracy puede llevar a conclusiones equivocadas.
Por último, también es habitual aplicar de forma manual las transformaciones durante el entrenamiento y la predicción. Esto aumenta el riesgo de ejecutar pasos diferentes o en un orden incorrecto. Para evitarlo, lo más recomendable es utilizar un Pipeline, ya que permite agrupar las transformaciones y el algoritmo en un único flujo y aplicar exactamente el mismo proceso sobre todos los datos.
Buenas prácticas con PySpark ML
Como hemos podido ver a lo largo del post, PySpark ML proporciona todas las herramientas necesarias para construir flujos completos de Machine Learning sobre grandes volúmenes de datos, desde la preparación de variables hasta el entrenamiento, la evaluación y el guardado del modelo. Sin embargo, para obtener resultados fiables no basta con seleccionar un algoritmo y ejecutar fit(). Además, es necesario mantener un proceso ordenado y controlar correctamente cada una de sus etapas.
Entre las principales buenas prácticas se encuentran dividir los datos antes de ajustar cualquier transformación que necesite aprender información, utilizar pipelines para asegurar que siempre se aplican los mismos pasos, seleccionar métricas adecuadas para cada problema y reservar el conjunto de test para la evaluación final. También es recomendable comenzar con modelos sencillos, utilizarlos como referencia y aumentar la complejidad únicamente cuando exista una mejora real en los resultados.
Por último, un modelo no debe considerarse válido únicamente porque obtenga una buena métrica. También es necesario comprobar que sus predicciones tengan sentido, que no exista fuga de información, que el rendimiento se mantenga sobre datos nuevos y que el coste computacional sea razonable. Seguir estas prácticas permitirá construir modelos más fiables, mantenibles y preparados para utilizarse en entornos reales.
Conclusión
En definitiva, PySpark ML no debe entenderse únicamente como una librería para entrenar algoritmos, sino como un conjunto de herramientas que permite organizar y ejecutar todo el ciclo de vida de un modelo de Machine Learning.
Conocer cómo funcionan sus transformadores, estimadores, pipelines y modelos entrenados es fundamental para construir soluciones que no solo generen buenas predicciones, sino que, además, sean reproducibles, escalables y fáciles de mantener.
Si este artículo te ha parecido interesante, te animamos a visitar la categoría Data Science para ver otros posts similares a este y a compartirlo en redes. ¡Hasta pronto!
