
La tarea de elegir, entrenar y desplegar un modelo temporal de predicción o de detección de anomalías es compleja, larga e incierta. Debido a la dificultad de trabajar con series temporales, tener un modelo rápido que sirva para tener un resultado base contra el que comprobar futuros modelos o desarrollos es extremadamente útil.
Recientemente, BigQuery introdujo en su suite de modelos ML su nueva versión de TimesFM, TimesFM 3.0. Este modelo, únicamente con una simple llamada en SQL desde BigQuery Studio, permite la creación de un modelo entrenado.
A diferencia de otros modelos populares como ARIMA, sigue una arquitectura Transformer similar a la de los predecesores de los LLMs. Lo interesante de esta característica es que limita la cantidad de componentes que especificar. Normalmente, antes de construir un modelo es necesario conocer la estacionalidad, tendencia y periodicidad de los datos. Sin embargo, con TimesFM 3.0, no existen estas limitaciones.
En este artículo, abordaremos qué es y cómo funciona TimesFM 3.0 para analizar si vale la pena usar este modelo y hasta qué punto es preciso.
Caso práctico BigQuery TimesFM 3.0
A continuación, veremos cómo funciona en la práctica TimesFM 3.0. Para ello, tomaremos un dataset de datos de ejemplo: NYC City Bike (que contiene información de 2013 a 2016), un dataset público y que además posee ciertas propiedades interesantes.
En primer lugar, lanzamos una query para obtener los datos:
WITH trips AS (
SELECT DATE(starttime) AS trip_date, COUNT(*) AS num_trips
FROM `bigquery-public-data.new_york.citibike_trips`
WHERE starttime IS NOT NULL
GROUP BY 1
)
SELECT trip_date, COALESCE(num_trips, 0) AS num_trips
FROM UNNEST(GENERATE_DATE_ARRAY((SELECT MIN(trip_date) FROM trips),
(SELECT MAX(trip_date) FROM trips))) AS trip_date
LEFT JOIN trips USING (trip_date)
ORDER BY trip_date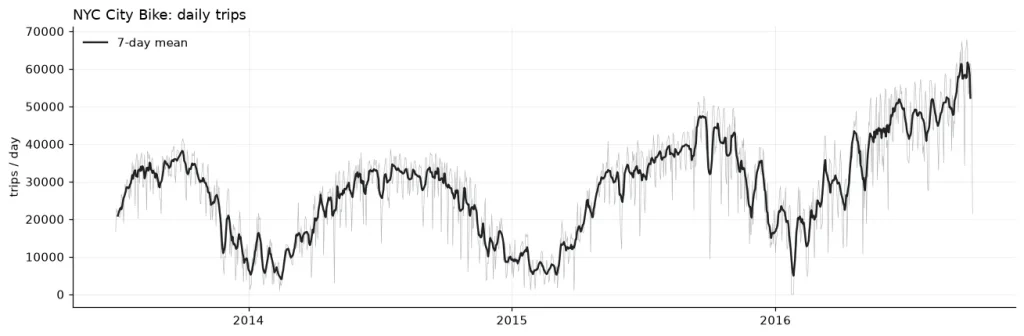
Tal y como se puede observar, los datos tienen una estacionalidad interesante. Cuando las temperaturas son más altas, la gente usa más el servicio. Sin embargo, cuando el frío aparece, la gente decide usarlo menos. Semanalmente, existe una periodicidad y también vemos que año a año hay un aumento gradual del uso, una tendencia. Incluso podemos observar algunas anomalías, como una caída más pronunciada de lo normal a inicios de 2016.
Estas propiedades hacen los datos suficientemente interesantes como para comprobar algunas funcionalidades básicas del modelo.
Forecasting con BigQuery TimesFM 3.0
Para evaluar el modelo, empezaremos con una prueba simple. Para ello, tomamos los datos de NYC City Bike hasta el 2016-07-01, y le pedimos que produzca los siguientes 60 días (horizonte 60).
SELECT *
FROM AI.FORECAST(
(SELECT trip_date, num_trips
FROM `dataset.nyc_daily`
WHERE trip_date < DATE '2016-07-01'),
  data_col         => 'num_trips',
  timestamp_col    => 'trip_date',
  model            => 'TimesFM 3.0',
  horizon          => 60,
  confidence_level => 0.9
)
ORDER BY forecast_timestamp
A continuación, generamos un gráfico con los resultados del modelo y observamos qué ocurre con el horizonte a partir del 1 de julio de 2017:
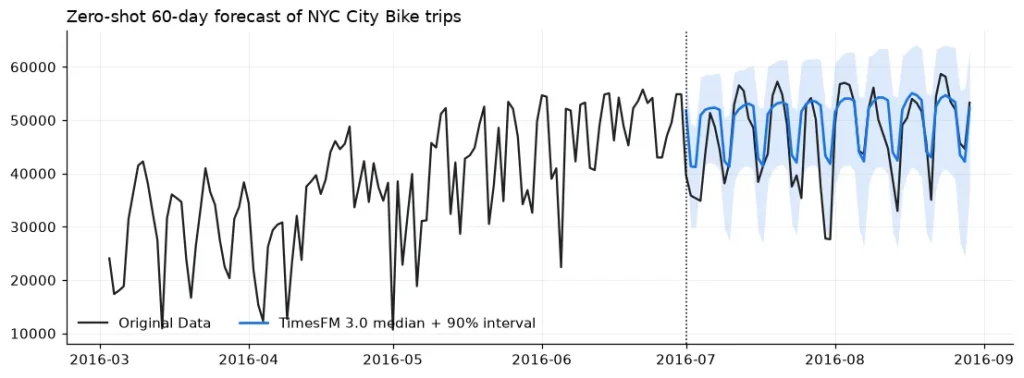
Sin ni siquiera tener que indicar la frecuencia de la periodicidad, el modelo la ha encontrado sin dificultades. Fuera de unos pocos casos, tenemos que el 91.67% de los días predichos están dentro de los intervalos de confianza del 90% del modelo.
Evaluación del resultado
Para evaluar el resultado, usaremos la función AI.EVALUATE de BigQuery, que permite evaluar un modelo de TimesFM contra el resultado histórico real.
| Modelo | mean_absolute_error (MAE) | mean_squared_error (MSQE) | root_mean_squared_error (RMSE) | mean_absolute_percentage_error (MAPE) | symmetric_mean_absolute_percentage_error (sMAPE) | mean_absolute_scaled_error (MASE) |
| TimesFM 3.0 | 4,424.26 | 37,026,770 | 6,084.96 | 11.06 % | 9.91 % | 0.755 |
Podemos observar que, de media, las predicciones no eran altas. Si analizamos únicamente las diferencias porcentualmente (MAPE), vemos que el modelo, de media, se separa un 11.06% de la realidad. Para ser un modelo entrenado en una sola llamada, sin optimizar hiperparámetros, es un resultado sorprendente.
Por otro lado, también podemos comparar el modelo 3.0 con su versión 2.5. que, en el momento de escribir este artículo, es el modelo por defecto. Así, podemos evaluar la mejora que ha conllevado el salto.
| Modelo | mean_absolute_error (MAE) | mean_squared_error (MSQE) | root_mean_squared_error (RMSE) | mean_absolute_percentage_error (MAPE) | symmetric_mean_absolute_percentage_error (sMAPE) | mean_absolute_scaled_error (MASE) |
| TimesFM 2.5 | 4,988.62 | 45,805,870 | 6,768.00 | 12.59 % | 11.13 % | 0.851 |
| TimesFM 3.0 | 4,424.26 | 37,026,770 | 6,084.96 | 11.06 % | 9.91 % | 0.755 |
El resultado en la versión 3.0 es mejor en todos los aspectos, lo que era de esperar, pero es interesante ver evidencia directa de ello.
Pero, ¿es mejor este resultado que la solución trivial, simplemente comparar con el pasado directamente, sin aplicar ningún cálculo?
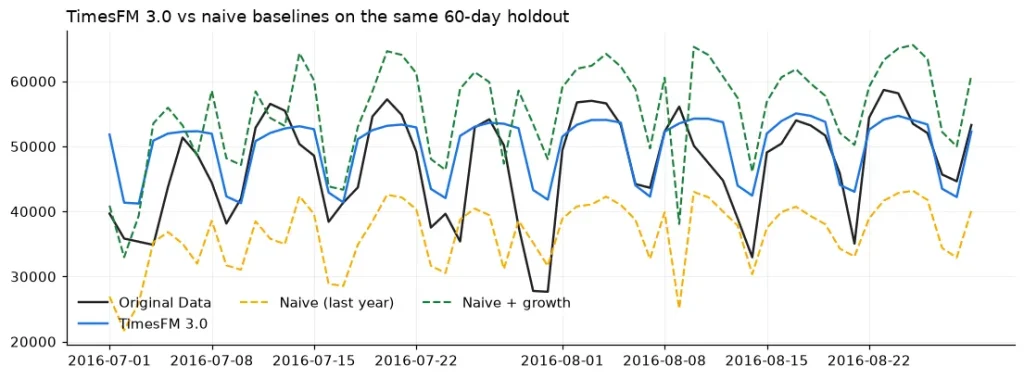
TimesFM 3.0 obtiene mejores resultados que los modelos más simples que pueden existir con los modelos simples obteniendo un MAPE de 22%.
Optimización de parámetros
Tal y como hemos visto, los modelos anteriores los obtuvimos sin modificar los parámetros. ¿Qué podríamos mejorar en caso de que sí los cambiásemos?
Existen dos parámetros. Por un lado, el horizonte, que solo cambia cuantos datos predice, (por ejemplo, horizonte de 30 serían 30 predicciones desde el corte) y, por otra parte, la context window, que calcula cuántos puntos en el pasado mira para predecir el valor.
En 3.0, la context windows por defecto siempre es 2048 (el valor máximo). Podemos ver cómo reducir esta cifra afecta a los resultados:
| context_window | MAE | RMSE | WAPE % | MAPE % | coverage % (points inside confidence interval) |
| 64 | 5107.71 | 6700.46 | 10.86 | 11.38 | 93.33 |
| 128 | 5448.34 | 6576.89 | 11.58 | 12.04 | 96.67 |
| 256 | 5113.19 | 6466.98 | 10.87 | 11.36 | 96.67 |
| 512 | 4505.97 | 6058.47 | 9.58 | 10.10 | 91.67 |
| 1024 | 4411.32 | 6063.77 | 9.38 | 9.89 | 91.67 |
| 2048 | 4424.26 | 6084.96 | 9.40 | 9.91 | 91.67 |
Aumentar la context window no siempre implica un mejor resultado. No obstante, en este caso específico, la diferencia es extremadamente menor entre el óptimo (1024) y el valor por defecto (2048). Aun así, parece que existe optimización posible al elegir el parámetro.
Detección de anomalías con BigQuery TimesFM 3.0
A diferencia de la simplicidad de forecasting, las anomalías requieren de dos entradas. Una de ellas es el valor histórico, que actúa como referencia, y la otra la fecha a partir de la cual predecir las anomalías.
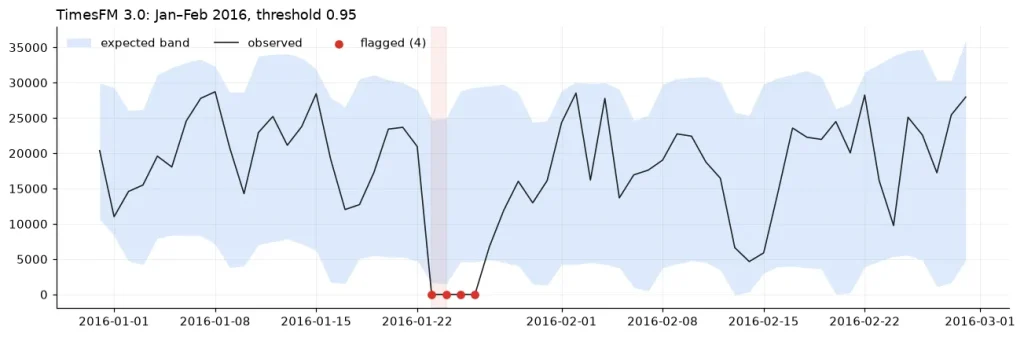
Como ejemplo, tomamos una anomalía conocida previamente. Por ejemplo, el 23 de enero del 2016, un evento suspende el servicio de Citi Bike en NY durante el fin de semana.
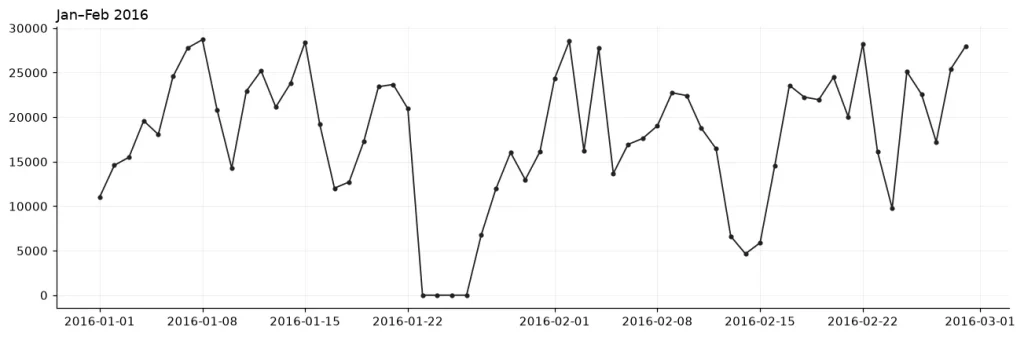
SELECT * FROM AI.DETECT_ANOMALIES(
(SELECT trip_date, num_trips FROM `dataset.nyc_daily` WHERE trip_date <= DATE '2016-02-29'),
data_col => 'num_trips',
timestamp_col => 'trip_date',
target_start_timestamp => TIMESTAMP '2015-12-31',
model => 'TimesFM 3.0',
anomaly_prob_threshold => 0.95)
Podemos ver que, en los resultados, el evento claramente anómalo es registrado como tal con una confianza del 95%.
Si expandimos el periodo de detección, vemos que, prácticamente, se encuentran las mismas anomalías y no parece que tengamos falsos positivos:
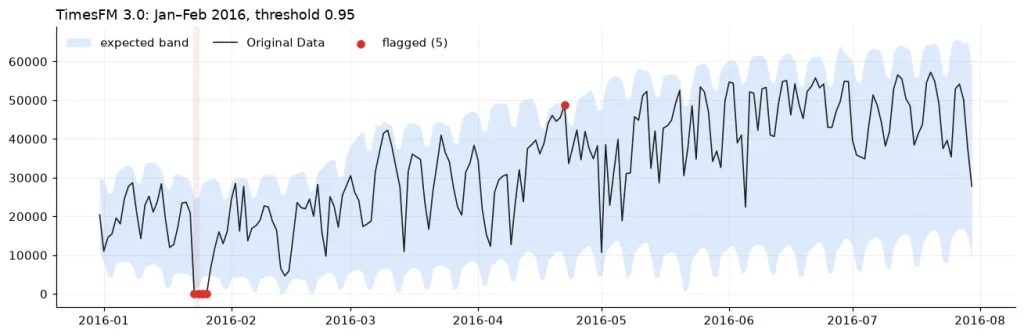
Hay un día que no esperamos marcado, 2016-04-22. Si lo analizamos, vemos que corresponde a la celebración del Día De la Tierra, donde en Nueva York tuvieron el primer “Car-Free Day”, cosa que puede explicar un valor anómalo alto en el uso del servicio.
No obstante, hemos de tener en cuenta que si alteramos el intervalo de confianza, las anomalías detectadas cambian.
Con un 80%, tenemos muchas más posibles anomalías:
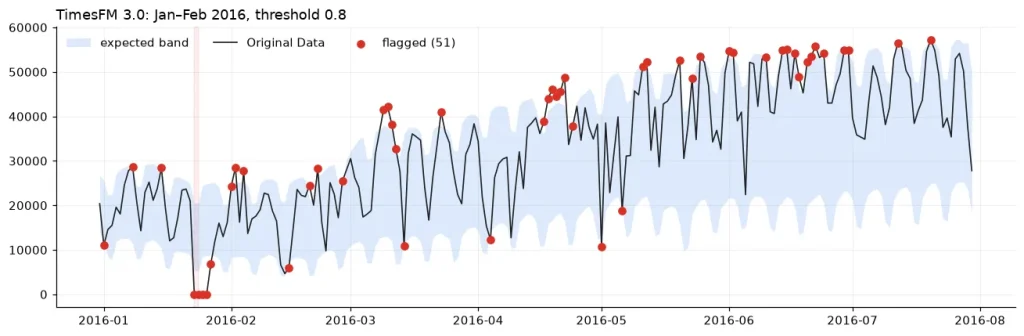
Mientras que, si indicamos 99%, tenemos el problema contrario, perdemos anomalías conocidas:
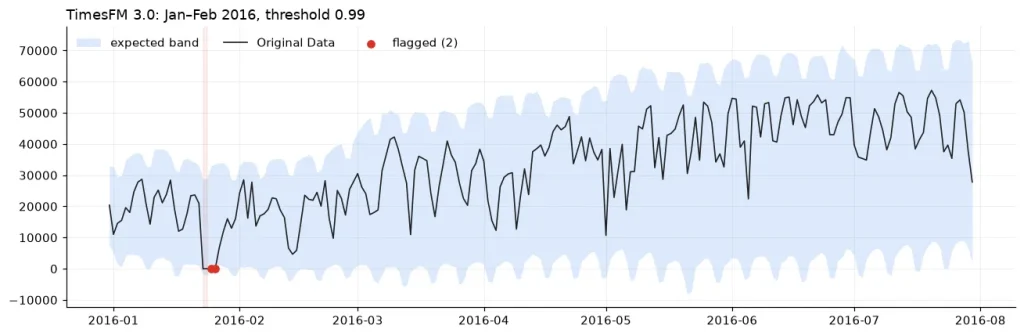
Dado que la detección de anomalías existe para alertar del comportamiento anómalo, es necesario definir previamente los límites de dichas anomalías antes de decidir el modelo.
Conclusión
Para tener un modelo mínimo operativo o un modelo de referencia sobre el que comprobar resultados, TimesFM 3.0 obtiene un buen rendimiento con pocos parámetros. Esta característica permite poder obtener conocimiento accionable de los datos con relativamente poco esfuerzo.
La facilidad de ejecutarlo desde BigQuery también ayuda a este propósito. Es una solución ideal si tus datos ya existen en ese entorno. Además, muestra mejoras respecto a su antigua versión.
Si este artículo te ha parecido interesante, te animamos a visitar la categoría Data Science para ver otros posts similares a este y a compartirlo en redes. ¡Hasta pronto!
