
SLQFluff es una herramienta de linting y autoformateo de código SQL que ya hemos abordado en artículos anteriores. En Optimización de SQL con SQLFluff analizamos cómo se instala desde cero y recorrimos los primeros pasos para utilizarla.
La implementación de SQLFluff en un proyecto es algo casi imprescindible para que las queries mantengan una armonía de estilo a lo largo de todo el código. Sin embargo, esta herramienta no solo está pensada para usarse en un equipo pequeño de desarrolladores. Su uso también se puede extender a equipos de mayor tamaño que buscan estandarizar el estilo de su código para facilitar su lectura y unificar el estilo de las diferentes consultas realizadas por todos los participantes.
Es aquí cuando aparecen los problemas, ya que un repositorio con cientos e incluso miles de consultas o modelos, pipelines de CI/CD y decenas de desarrolladores trabajando en paralelo, convierte el linting en algo muchísimo más complejo de gestionar. Algo que en local es un procedimiento sencillo, se puede convertir en mucho tiempo de espera en un Pull Request. Además, a la larga, en lugar de ser algo que ayude al equipo, podría convertirse en una fuente de conflictos y tensiones entre ellos.
Por este motivo, en este artículo hablaremos de cómo se debe de integrar SQLFluff en entornos reales, permitiendo mantener tiempos estables y razonables de ejecución y evitar bloqueos en el CI por problemas de estilo.
Desafíos de la integración en producción
Una vez que un desarrollador tiene su código listo, el siguiente paso es integrarlo dentro de un sistema mayor. Ahí es donde se utiliza el tan conocido CI/CD, que no significa otra cosa que integración continua y despliegue continuo. Aunque pueda parecer contraintuitivo, es en este punto donde aparecen los primeros problemas. En la mayoría de los casos, estos problemas no están relacionados con reglas de estilo, pero sí que están influidos por cómo están construidas las consultas. Uno de los más habituales está relacionado con el proceso de renderizado que SQLFluff necesita efectuar para poder realizar el análisis del código.
El coste de usar dbt templater
Cuando usamos SQLFluff en un proyecto sobre modelos de dbt, éste no analiza directamente el contenido de los ficheros SQL. Antes de eso, tiene que resolver todo lo que se utiliza en el código dbt como macros, variables, referencias a otras tablas o fuentes de datos y todos los elementos de Jinja que dbt usa para su funcionamiento. Para hacer todo este proceso, SQLFluff utiliza el dbt templater.
Por si no estás familiarizado con el funcionamiento de dbt, explicaremos rápidamente qué es dbt templater y cuál es su función. Dbt templater es el componente encargado de renderizar los modelos SQL utilizando el contexto real del proyecto. Gracias a ello, se genera una versión compilada que SQLFluff puede interpretar y analizar correctamente.
Un ejemplo sería el siguiente:
-- Query de dbt
SELECT
    hotel_id,
    checkin_date,
    checkout_date,
    room_type
FROM {{ ref('stg_hotel_bookings') }}
WHERE checkin_date >= '{{ var("start_date") }}'
Y, una vez que dbt templater lo ha renderizado, SQLFluff analizaría la siguiente query resultante.
-- Query tras renderizado
SELECT
    hotel_id,
    checkin_date,
    checkout_date,
    room_type
FROM dataset.stg_hotel_bookings
WHERE checkin_date >= '2026-05-29'
De esta forma, SQLFluff puede validar el SQL real que finalmente será ejecutado por el motor de base de datos.
Inconvenientes de dbt templater
El inconveniente es que, para que se valide un único archivo SQL, dbt templater puede necesitar cargar una buena parte del proyecto de dbt. Esto, en códigos relativamente pequeños, no debería de ser un problema. Sin embargo, si agrandamos la escala y empezamos a usar SQLFluff en repositorios con cientos o incluso miles de modelos, cada ejecución del linter implica aumentar considerablemente los tiempos de ejecución de la integración continua.
Además, otro gran problema que hay cuando se usa SQLFluff en entornos de producción es relativo al acceso. Cuando se ejecuta dentro de una pipeline de integración continua, dbt templater necesita acceder a la configuración completa del proyecto, incluido perfiles, variables de entorno e incluso credenciales de acceso.
Esto, que a priori podría no suponer un factor determinante, se convierte en un problema cuando obliga a replicar la configuración de la ejecución de dbt dentro del proceso de CI, ya que aumenta la dificultad a la hora de realizar el mantenimiento y la dependencia en sistemas externos.
Por estas dos razones principales, cuando los proyectos son de una dimensión considerable, es recomendable separar el proceso de linting del entorno de ejecución. De esta manera, SQLFluff podrá analizar los modelos sin necesidad de establecer conexiones con la infraestructura de datos.
CI desconectada y entornos híbridos
Dado que el uso principal de SQLFluff es ejecutar un proceso de linting en nuestro código SQL, una práctica muy recomendable sería desacoplar todo lo relacionado con SQLFluff del data warehouse durante el proceso de integración continua.
Para hacerlo, una de las posibles opciones es definir un target específico dentro del fichero profiles.yml que esté destinado exclusivamente a este fin. De esta manera, cuando durante el proceso se ejecute SQLFluff, no se conectará a ningún data warehouse. Únicamente tendrá una configuración mínima que le permita renderizar los modelos para poder realizar el linting correspondiente.
Para mostrar cómo implementar este proceso con un ejemplo, vamos a suponer que nuestro fichero profiles.yml es el siguiente:
my_dbt_project:
  target: lint
  outputs:
    lint:
      type: bigquery
      project: lint-project
      dataset: lint_dataset
      location: europe-west2
      method: service-account
      threads: 1

    dev:
      type: bigquery
      project: development-project
      dataset: analytics
      location: europe-west2
      method: service-account
      threads: 3

    prod:
      type: bigquery
      project: production-project
      dataset: analytics
      location: europe-west2
      method: service-account
      threads: 6
Como se puede ver, hay un target definido que es lint que asocia el proyecto y el dataset con una configuración específica destinada exclusivamente al proceso de linting. De esta manera, SQLFluff puede renderizar el modelo minimizando la necesidad de utilizar configuraciones de desarrollo o producción, facilitando así todo el proceso de CI/CD.
Por otro lado, si bien es cierto que esta estrategia permite simplificar el proceso,porque evita exponer credenciales, mantiene otro reto que hay que abordar cuando se trabaja con SQLFluff. Hay que gestionar el uso de variables dinámicas y expresiones Jinja que únicamente existen en tiempo de ejecución del proceso. Así pues, vamos a analizar cómo tratar con este problema.
Gestionando variables dinámicas
Tal y como hemos mencionado, otro problema frecuente de SQLFLuff en entornos productivos es el uso de las variables dinámicas o expresiones Jinja que se renderizan en tiempo de ejecución.
Un ejemplo de esta casuística podría ser el empleo en un modelo de dbt que use una variable como por ejemplo:
{{ var('start_date') }}Desde el punto de vista de dbt, esto es perfectamente válido. Sin embargo, SQLFluff no conoce el valor de esa variable durante el análisis que realiza del código. Por lo tanto, el proceso de linting acaba con errores de templating aunque la consulta sea correcta y funcional.
La solución a este problema es relativamente simple. Consiste en darle a SQLFluff el contexto necesario para que sepa de manera automática cómo resolverlo. A pesar de que parece complicado, se puede hacer mediante la creación del fichero de configuración generado durante la configuración básica del artículo anterior. Simplemente, y siguiendo lo establecido en el ejemplo anterior de la variable, tendríamos que añadir lo siguiente a nuestro fichero .sqlfluff:
[sqlfluff:templater:dbt:context]
start_date = 2026-05-29
Con este bloque, lo que hacemos es establecer valores simulados para las variables definidas mediante var() en dbt en el momento del renderizado. De tal manera que SQLFluff pueda interpretar el código sin necesidad de conocer el contexto completo de ejecución.
Como puedes imaginar, esto es especialmente importante en proyectos en los que dbt, Jinja, macros o variables dinámicas tengan un papel importante. Gracias a ello, SQLFluff hará sus procesos de manera mucho más sencilla y, sobre todo, eficiente.
Optimizando el alcance del linting
Ahora que ya hemos hablado de dos de los problemas más importantes relacionados con la configuración de SQLFluff en un proyecto de grandes dimensiones, el siguiente punto es analizar el tiempo de ejecución del proceso de linting. Aunque no es algo que afecte al código en sí, ejecutar un análisis sobre un repositorio completo cada vez que se hace un Pull Request no es la mejor idea. Podría llegar a convertirse en un gran cuello de botella del proyecto.
Como es lógico, durante un desarrollo únicamente se suelen modificar o añadir unos pocos modelos dentro del repositorio. Sin embargo, si no se configura adecuadamente, la integración continua puede ejecutar un análisis de todos los ficheros SQL del repositorio en cada Pull Request. Esto, como te puedes imaginar, no solo es innecesario, sino que es completamente ineficiente. Cada nueva subida repetirá el mismo procedimiento y revisará el mismo código una y otra vez.
Por esta razón, una práctica habitual es limitar el análisis solo a los ficheros que se han modificado respecto a lo que ya hay en la rama principal del repositorio. De esta manera, SQLFluff únicamente analiza los ficheros que verdaderamente necesitan revisión, ya que han sufrido cambios y pueden contener errores de linting.
Control de versiones
Para realizar esta configuración, lo más cómodo es apoyarse en el propio sistema de control de versiones. De esta manera, podremos saber qué ficheros han sido los que se han modificado y sobre los que habrá que ejecutar el linting.
Por ejemplo, en un entorno basado en Git, podemos obtener todos los ficheros modificados respecto a la rama main mediante el siguiente comando:
git diff --name-only origin/main...HEADA partir de este resultado, únicamente será necesario filtrar los ficheros SQL y ejecutar SQLFluff sobre ellos.
sqlfluff lint $(git diff --name-only origin/main...HEAD | grep '\.sql$')De esta forma, el proceso de linting deja de depender del tamaño total del repositorio y pasa a depender exclusivamente del volumen de cambios introducidos en cada Pull Request.
Por otro lado, como es lógico, estos comandos no se ejecutan manualmente. Lo habitual es integrarlos dentro de la pipeline de integración continua para que se ejecuten automáticamente durante el proceso de validación de cada Pull Request.
Además, integrar SQLFluff dentro del proceso de CI/CD aporta una ventaja importante respecto a las validaciones que se hacen en local durante el desarrollo. Y es que, aunque se haya configurado y usado el pre-commit (como se explicó en el post anterior), para realizar el linting cada vez que se realiza un commit, éste depende de la configuración que tenga cada desarrollador. Por el contrario, si se realiza en el proceso de integración continua, se garantiza que todos los cambios realizados cumplen con las mismas reglas antes de ser integrados en la rama principal.
Por ese motivo, en entornos de producción es habitual usar ambos enfoques. Primero, cada desarrollador valida el código en su local antes de hacer un commit con el pre-commit. Después, el código se vuelve a validar en el proceso de integración continua verificando que sigue las reglas especificadas a nivel centralizado. De esta manera, se mantiene un proceso de validación consistente durante todo el ciclo de desarrollo.
Estrategias de adopción progresiva en equipos
Hasta ahora, en ambos artículos sobre SQLFluff, hemos estado viendo cómo optimizar la herramienta desde un punto de vista técnico. Sin embargo, existe una parte que es igual de importante a la hora de usar un linter: conseguir que el equipo sea capaz de usar la herramienta sin generar tensiones ni fricción.
Este punto es crucial, porque usar un linter no es solo instalarlo, activar todas las reglas y ejecutarlo. En proyectos grandes, con cientos de modelos y multitud de miembros en un equipo, esta estrategia normalmente genera más problemas de los que resuelve.
Por esa razón, en entornos reales que ya están en funcionamiento es mucho más inteligente y efectivo introducir SQLFluff de manera progresiva. De esta forma, el equipo podrá ir adaptándose poco a poco evitando que se convierta en un foco de conflicto entre los desarrolladores.
Dicho esto, vamos a ver algunas estrategias que se pueden usar para conseguir integrar de manera efectiva SQLFluff en equipos.
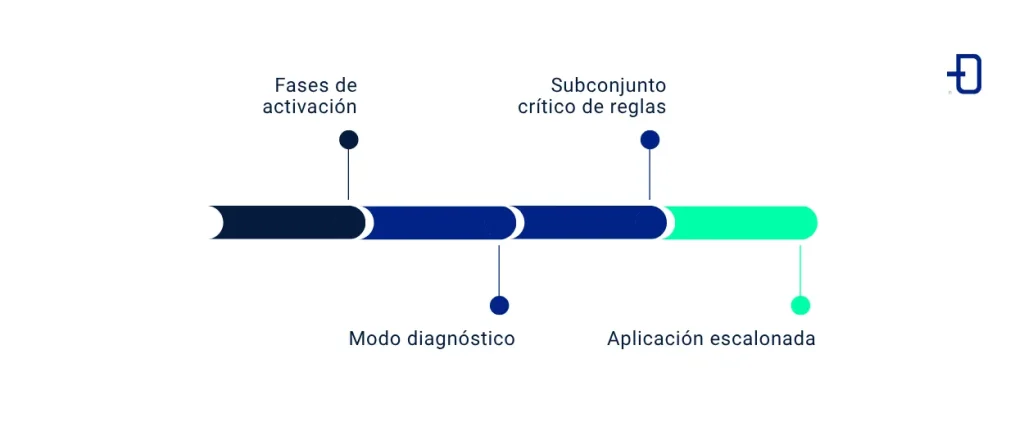
Fases de activación
Cuando se intenta introducir un linter como SQLFluff en un código que ya tiene cientos o incluso miles de consultas, un error sería pensar que se deben activar todas las reglas para todo el código desde el primer momento. Si se hace así, probablemente no solo va a generar una cantidad ingente de modificaciones casi imposible de revisar. Además, se convertirá en una fuente de fricción enorme para los desarrolladores.
Por esa razón, una forma mucho más inteligente de realizar el proceso es activar SQLFluff de manera escalonada y progresiva. Lo ideal es seguir una hoja de ruta que primero permita ver cuál es el alcance de las correcciones para luego implementarlas de manera ordenada sin generar discrepancias.
Modo diagnóstico
La primera fase es ejecutar SQLFluff dentro de la pipeline de CI/CD pero sin bloquear el Pull Request en caso de que se detecten errores. De esta manera, podemos conocer el estado del repositorio y el volumen de cambios a realizar para implementar todas las reglas de linting deseadas.
Esto es importante realizarlo en primer lugar. En un proyecto legacy, lo normal es encontrar cientos de incumplimientos de las reglas establecidas, acumuladas durante años en todo el código. Si dichas reglas se quieren ajustar de una sola vez, pueden romperlo con facilidad. Por esa razón, en esta fase lo que se busca no es corregirlo todo de golpe, sino medir la deuda que hay en todo el repositorio.
Subconjunto crítico de reglas
Una vez que se conoce el alcance de los cambios a realizar, vamos hacia el siguiente paso. En lugar de activar todas las reglas a la vez, se establecen una serie de reglas base que son imprescindibles para el proyecto. Por ejemplo, las reglas de uso obligatorio de alias, referencias ambiguas o empleo de estructuras base.
En este punto es crucial centrarse en lo importante y ponerlo por encima de la estética. Por ejemplo, determinar si un dataset ha de estar en el mismo renglón que el FROM o en uno aparte no es tan relevante para el código como sí lo puede ser establecer que los alias han de tener al menos tres letras para ganar en legibilidad.
Aplicación escalonada
Llegados a este punto, ya se deben haber implementado las primeras reglas y realizado los primeros ajustes en el código. El siguiente paso es ir añadiendo nuevas reglas que vayan resolviendo diferentes problemas de linting de nuestro código. Este endurecimiento puede hacerse de varias formas.
La primera opción es activar el bloqueo por carpetas, empezando por las zonas más críticas del proyecto. Esto hace que poco a poco se vaya arreglando el código manteniendo las partes vitales fuera de posibles modificaciones. Otra alternativa puede ser por calendario, de manera que cada semana o cada mes se agreguen nuevas reglas a todo el repositorio.
La clave en estos puntos es que los cambios sean predecibles. De esta forma, todo el equipo será consciente de qué cambios se van a aplicar y podrán integrarlos en su manera de generar las consultas. Además, haciéndolo progresivo, SQLFluff deja de considerarse como un problema al que hay que adaptarse y pasa a ser un proceso que se está implementando y que aporta funcionalidad a la manera en la que se trabaja dentro del equipo.
Noqa y el peligro que supone
Ya hemos comprobado lo importante que es el linting para mantener la calidad y homogeneidad del código y cómo implementarlo dentro de entornos productivos de manera escalonada y progresiva. El siguiente punto a tener en cuenta es cómo conseguir que los desarrolladores adopten estas reglas de linting en su día a día en lugar de buscar estrategias que les permita esquivarlas.
La manera más rápida y sencilla de evitar una regla concreta consiste en usar la directiva noqa. Por ejemplo, si tenemos activada la regla AM04, que prohíbe el uso de SELECT *, obligando a declarar las columnas utilizadas explícitamente, el siguiente código nos dará un error de linting:
SELECT *
FROM my_table
Sin embargo, si en este mismo código desactivamos mediante la directiva noqa esa regla concreta, el linting dejará de fallar:
-- noqa: disable=AM04
SELECT *
FROM my_table
-- noqa: enable=AM04
Esto puede llegar a convertirse en un problema, porque si se hace de manera recurrente en lugar de ser un acto puntual, el linter pierde por completo su utilidad y el código vuelve a convertirse en algo poco escalable y difícil de mantener.
Por esa razón, aunque noqa puede ser una herramienta muy útil para gestionar excepciones necesarias en determinadas partes del código, no debería usarse como solución por defecto. El objetivo no es prohibir su uso, sino garantizar que cada excepción esté claramente identificada y justificada y pueda revisarse cuando sea necesario. De esta manera, noqa sigue siendo una herramienta muy útil. Sin embargo, si se usa indiscriminadamente, puede arruinar el esfuerzo que se está haciendo por conseguir un código mantenible y escalable.
Separar el autofix de la lógica de negocio
Otro problema frecuente cuando se introduce SQLFluff en un proyecto con una gran cantidad de código legacy aparece durante las revisiones de código.
Por ejemplo, un desarrollador introduce un cambio pequeño de una o dos líneas en un fichero que tiene código legacy. Si sobre este código, que nunca antes había sido formateado, se le aplica un sqlfluff fix antes de realizar un commit, el resultado va a ser que el Pull Request resultante tenga cientos de cambios que se han de revisar a pesar de que el cambio importante sean únicamente una o dos líneas.
En estos casos, el problema no es el linting. Lo que ocurre es que se vuelve prácticamente imposible realizar una revisión de código efectiva. Si se mezclan cambios de estilos con cambios funcionales, se vuelve muy complicado distinguir una parte de la otra. Por esa razón, en estos casos lo normal es hacer una separación clara entre ambos tipos de cambios. Las modificaciones funcionales del código se han de mantener en una rama independiente. Por otra parte, todo lo que esté relacionado con el proceso de formateo se llevará a cabo en una rama específica a la que se le aplicará un sqlfluff fix para arreglar todos los problemas de linting.
De esta manera, se consigue que cada Pull Request tenga un objetivo claramente diferenciado. Además, será mucho más fácil e intuitivo para los desarrolladores que tienen que revisar el código saber en qué han de fijarse en cada uno de ellos. De esta manera, se reduce el riesgo de cometer errores y se facilita el seguimiento del histórico a lo largo del repositorio.
Conclusión
Como hemos podido ver a lo largo de todo el post, cuando los proyectos crecen, introducir un linter deja de ser algo trivial para convertirse en un proceso que hay que planificar cuidadosamente. Aspectos como el rendimiento de la integración continua, la gestión del código legacy, la adopción de mecanismos de linting por parte de todo el equipo o el impacto de estas modificaciones en los procesos de revisión de código son puntos tan importantes como la propia configuración de la herramienta.
Por esa razón, que SQLFluff se integre correctamente en entornos productivos no depende únicamente de definir un conjunto de reglas adecuado. También es cuestión de integrarlo correctamente dentro de la forma de trabajar del equipo. Si se hace de manera progresiva, manteniendo un control y trazabilidad en los cambios, se podrá ver como todo el proyecto gana en consistencia y legibilidad. Sin embargo, si se hace de forma descontrolada puede dar lugar a un código aún más legacy y a un equipo descoordinado que no sabe qué reglas aplicar o en qué momento hacerlo.
En resumen, SQLFluff no solo ayuda a mantener un código más consistente y legible, sino que también puede convertirse en una herramienta clave para mejorar la mantenibilidad del proyecto a largo plazo. Sin embargo, para conseguirlo, es imprescindible acompañar su adopción con una estrategia clara y bien definida desde el principio.
Si este artículo te ha parecido interesante, te animamos a visitar la categoría Data Engineering para ver otros posts similares a este y a compartirlo en redes. ¡Hasta pronto!
