
Con la reciente salida de la beta de DBT v2, la herramienta de transformación de datos marca su mayor actualización hasta el momento. Siendo un cambio tan considerable, vale la pena analizar qué conlleva y qué se replantea.
Novedades principales de DBT 2.0
A continuación, analizaremos las principales novedades de la nueva versión de DBT que a partir de septiembre de 2026 ya está disponible para general access.
La primera de ellas, es que ahora la herramienta presenta dos distribuciones. Así pues, dbt v2 tendrá dos paquetes: dbt-core-v2 y dbt (el antiguo dbt fusion). Ambos se podrán usar gratis, pero las funcionalidades de pago quedan dentro de DBT. Por otra parte, dbt-core v2 solo contiene código open source y ninguna funcionalidad de pago, mientras que dbt contiene código privativo distribuido como binario.
Otra innovación que trae esta nueva versión es el cambio de motor. La nueva base de dbt-core es en Rust, no Python puro como en la v1. Esto ocurre debido a que el motor de dbt fusion pasa a ser usado en dbt-core-v2, permitiendo una mayor velocidad de ejecución.
Por otra parte, hay nuevos artefactos basados en Parquet. Antiguamente, proyectos grandes de DBT tenían el problema de que ciertos ficheros se hacían difíciles de alterar y leer al ser un gran JSON. Ahora, se guardan en Parquet permitiendo una lectura e indexación rápidas.
Además, DBT ya continúa compilando cuando hay errores. Previamente, si un nodo no se podía compilar debido a un error, DBT paraba inmediatamente. Ahora, no compilará ningún nodo downstream, pero seguirá compilando otros nodos si existen.
Mayor rigurosidad en especificación y parseo
Parte considerable de los cambios a dbt v2 corresponden a una mayor rigurosidad con la especificación y el parseo. Antes, DBT solía fallar silenciosamente, solucionaba conflictos en el fondo en lugar de hacerlo explícito y esperaba hasta la compilación para detectar errores. Con el paso a v2 se quiere evitar este proceso y, para ello, existen las funcionalidades que analizaremos a continuación.
Especificación de lenguaje estricta
Anteriormente, DBT fallaba silenciosamente cuando encontraba lenguaje mal definido, por ejemplo, “descriptin” en lugar de “description”. Esto deja de ser un problema, con lo cual se evitan bugs silenciosos.
Fallo en tiempo de parseo
En lugar de fallar en tiempo de compilación, cuando detecte macros o adaptadores inexistentes, tests no definidos o variables no definidas, arrojará error sin necesidad de esperar al compilado.
Conflictos de paquetes
En la versión anterior, si existía un conflicto de dependencias, anteriormente se resolvía silenciosamente a favor del paquete raíz, ahora generará un error.
Documentación duplicada
La versión 1 permitía la creación de bloques de documentación duplicados. Sin embargo, en la 2 se evalúan los nombres de forma más estricta para prevenir ambigüedad. Así, en caso de que se produzca un conflicto, fallará.
Claves de primer nivel
La presencia de claves inesperadas en el primer nivel en un fichero YAML ahora provocarán un error. Si se quieren usar para definir un bloque reusable, ha de hacerse bajo la llave :anchors.
Operaciones algebraicas en Jinja
Ya no es posible incluir funciones algebraicas dentro de una macro de Jinja, como sí ocurría anteriormente.
Cambios en los parámetros y modificadores de dbt v2
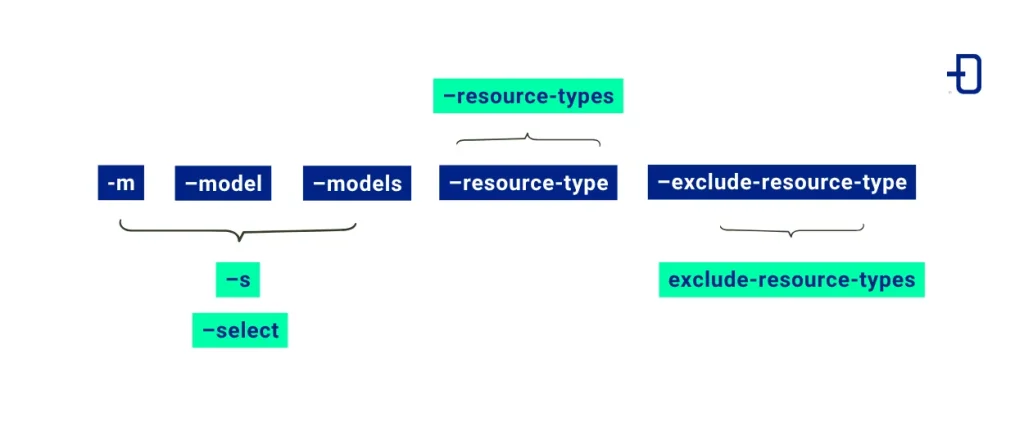
Se han deprecado una cantidad considerable de flags del CLI que no serán usadas en v2, de especial importancia son las siguientes:
- -m / –model / –models: Se ha de usar
–selecto-s. - –resource-type / –exclude-resource-type: Se ha de usar
–resource-typesoexclude-resource-types.
Si se utiliza alguna de las dos flags anteriores, causará un fallo en el CLI. Otras flags depreciadas, simplemente serán ignoradas y no causarán errores.
Debido al cambio considerable que la actualización de v1.12.0 a v2 conlleva, se han añadido dos herramientas para facilitar la transición:
- Parser de prueba. Se puede indicar la flag
--use-v2-parserpara forzar a usar el parser en v2. Esto nos permitirá probar si es necesario aplicar algún cambio. - Autofix. Existe también una herramienta publicada que facilitará la transición, el
dbt-autofix. Su misión es leer la configuración del proyecto y actualizarla para la versión v2.
Conclusión
DBT v2 supone una mejora considerable en los tiempos de ejecución y compilado. Además, gracias al cambio de motor y al paso de Python puro a Rust que aprovecha esta característica, se añade mayor rigurosidad para evitar los problemas comunes que previamente originaban bugs silenciosos (donde, debido a una mala definición, no se genera un error y el comportamiento deja de ser el esperado).
Con los nuevos cambios, DBT pasa a ser una herramienta más mantenible y eficiente. Asimismo, la convierte en una muy buena opción para cualquier tarea de procesamiento de datos basada en SQL.
Si este artículo te ha parecido interesante, te animamos a visitar la categoría Data Engineering para ver otros posts similares a este y a compartirlo en redes. ¡Hasta pronto!
